MODEL FIELD GUIDE 2026.09.06
GPT-6 Astraは何がすごい?
3D制作・アプリ操作・ポケモン18時間の実例
GPT-6 Astraの強みは、答えを返すことだけではありません。Blenderで形を作り、Unreal Engine 5で歩ける空間にし、画面のあるアプリを操作し、長いゲームの目的へ進み続ける。1回の回答で終わらない仕事を任せると、違いが出ます。
OpenAIが2026年9月3日に発表した新モデルで、ARC-AGI-3の99.9%(Provider Adapter / high)が大きく報じられました。この記事では、その数字だけでなく、公式の3D・ゲーム制作例、computer use、そしてコミュニティが公開したポケモンFireRedの18時間12分クリア記録を、条件と一緒に見ていきます。
発表・提供状況:OpenAIの発表/安全性:Safety overview
01 / CAPABILITY
Astraは、調査・実装・検証を一つの仕事として任せる。
文章が少し自然になったかより、途中で前提が変わる仕事を最後まで進められるかで差が出ます。Astraに向くのは、資料を読み、方針を選び、成果物を作り、結果を確かめる工程が一つにつながっている仕事です。
OpenAIは、複雑な推論、コード作成、コンピューター操作、調査、文書作成を主な用途に挙げています。こうした仕事を道具を使いながら進める仕組みをエージェントと呼びます。入力として目的・資料・権限を渡し、出力として成果物・検証結果・未確認点を受け取る使い方です。[モデル仕様]
| 評価 | GPT-6 Astra | GPT-5.6 Sol | 仕事で見る点 |
|---|---|---|---|
| Terminal-Bench 4.0 | 57.9% | 37.3% | コード修正を最後まで進める |
| Terminal-Bench Science 0.1 | 64.6% | 22.4% | データ分析・シミュレーション |
| AutomationBench | 41.4% | 18.1% | 複数ツールをまたぐ作業 |
たとえばTerminal-Bench Scienceは、データ分析やシミュレーションなどをコードと操作ツールで進める評価です。知識を答える能力に加えて、複数の工程を実行する能力の伸びが見えます。[発表本文・評価条件]
自社ツールへ組み込む場合は、105万トークンの文脈と12万8千トークンの最大出力を使って、大量の資料や長いコードベースを一つの仕事に渡せます。テキスト・画像に加え、Web検索、ファイル検索、コード実行、ホスト型シェル、画像生成、computer use、MCPをResponses APIから呼べます。推論設定はlowからmaxまでで、モデルIDはgpt-6-astraです。[モデル仕様] [最新モデルガイド]
数時間かかる調査や操作をAPIで動かすなら、ツールを待つ非同期ツール呼び出しと、途中で要件を変えるステアリングが役立ちます。実装側では、状態、タイムアウト、キャンセル、権限を管理し、途中経過と最終成果物を保存してください。モデルを選ぶだけで実行環境が自動的に用意されるわけではありません。
一方、公式表でも全項目で首位ではありません。「あらゆる仕事で最強」と受け取るより、今のモデルが途中で行き詰まる仕事で、完了までの差を測るほうが、導入の判断材料になります。
02 / 3D & GAME MAKING
Blenderで3Dを作り、Unreal Engine 5で歩けるゲーム空間へ。
GPT-6 Astraは、3Dモデルを一枚の画像で終わらせず、編集と確認を含む制作工程へつなげる用途で強みが見えます。OpenAIのBenchCADでは、複数方向から見たレンダーをもとにCADコードで立体を再構成し、ツール付きで幾何学的な重なり95.9%を記録しました。GPT-5.6 Solは83.3%、Claude Fable 5.1は84.3%です。[BenchCADの定義と比較]
さらに公式の実例では、Astraが家をBlenderでモデル化し、Unreal Engine 5で歩けるシーンへ変換しています。同じ発表ページには、画面や動きを含むカートレースゲームを作り、非技術者が遊べる形で公開する例もあります。Astraは、形を考える、素材を配置する、コードやシーンを修正する、実際に歩いて確かめる、という往復を一つの依頼へまとめやすいモデルです。[Blender・Unreal Engine 5・ゲーム制作の公式例]
もちろん、これだけで「どんな3Dアプリでも自動で完成する」とは言えません。BenchCADが測るのは形状の再構成で、実際の制作では寸法、トポロジー、マテリアル、ライセンス、レンダラーのバージョンまで合っている必要があります。公式例も、Astraと実行環境・ツールを組み合わせたショーケースです。試すときは、編集可能なモデル、ゲームで歩けるシーン、再生成スクリプト、複数ビューの検証を一つの成果物として指定すると、強みを判断しやすくなります。
参照画像と制約をそろえる
正面・側面・上面の画像、既知の寸法、単位、可動部、出力先(Blender、OpenSCAD、Three.jsなど)、対象バージョンを渡します。曖昧な寸法は「推定」と明記させます。
編集可能なデータを段階的に作る
まず形状と座標系、次に部品・マテリアル・カメラ、最後に書き出しと表示を分けます。AstraにはPython、CADコード、シーン定義、必要ならcomputer useを選ばせ、各段階でレンダーを確認させます。
ファイルと検証結果を残す
.blendや.glbだけでなく、再生成できるスクリプト、使用バージョン、推定した寸法、代表ビューのレンダー、既知の欠落をセットで受け取ります。製造や設計の最終判断は専門家が行います。
| 確認するもの | 質問 | 合格の証拠 |
|---|---|---|
| 形状 | 指定した寸法・比率・部品数になっているか | 寸法表、複数ビュー、必要なら測定ログ |
| 編集性 | 後から部品や材質を変更できるか | レイヤー/部品名、元スクリプト、再生成手順 |
| 表示 | 対象アプリと書き出し先で正しく見えるか | 指定バージョンでのレンダーと読み込み確認 |
貼り付け用 / 3Dモデル作成の例
添付した正面・側面画像をもとに、Blenderで編集可能な3Dモデルを作成してください。

最初に、確定している寸法、推定が必要な寸法、不足している参照画像を整理してください。
形状 → 部品分け → マテリアル → GLB出力の順で進め、各段階でレンダーを確認してください。
推定した値は一覧に残してください。

完成条件:
- 正面・側面・斜めから形状を確認できる
- オブジェクトが意味のある単位で分割されている
- GLBとして再読み込みできる
- 未確定箇所が一覧になっている
最初の題材は、寸法が少なく、何度でも作り直せる小さな家具や部屋の一部が向いています。参照画像から形を起こし、編集可能なファイルを生成し、三方向のレンダーを元画像と見比べる。ここまでを一つの完了条件にすると、3Dの得意不得意を判断しやすくなります。
03 / COMPUTER USE
computer useで、ブラウザからデスクトップアプリまで操作する。
Astraのcomputer useは、画面のあるアプリを幅広く扱うための機能です。フォーム入力、CRM更新、カレンダー整理、メールや文書の下書き、科学ソフトのデータ確認、WebサイトのフロントエンドQAに加えて、Blenderのような制作アプリも対象にできます。専用APIが用意されていないアプリでも、画面を読み、クリック、入力、スクロール、コード実行を組み合わせて、目的の作業を進めます。[Computer use APIガイド] [公式の利用例]
操作できる範囲は、Astraに接続した実行環境の範囲で決まります。ブラウザだけを渡した環境でネイティブアプリを開くことはできません。macOSやWindowsのデスクトップアプリを使う場合は、対応クライアント、対象アプリへの接続、権限、管理者ポリシーをそろえます。企業向け設定では、アプリ単位の許可・禁止や保存済み承認も管理できます。[管理者向けComputer Use設定]
| 評価 | GPT-6 Astra | GPT-5.6 Sol | 何を見るか |
|---|---|---|---|
| Agents' Last Exam | 59.3% | 53.6% | 実務に近い複合操作 |
| OSWorld 2.0 | 72.6% | 65.7% | デスクトップUIの操作 |
| ScreenSpot-Pro | 92.7% | 76.9% | 画面上の対象を見つける精度 |
実務で最初に試しやすいのは、「入力する → 更新する → 結果を確認する」が一つの仕事になっている作業です。OpenAIは、フォーム入力、CRM更新、カレンダー整理、メールや文書の下書き、科学ソフトのデータ確認、WebサイトのフロントエンドQA、Power BIやExcelに関係する操作を例に挙げています。[公式のcomputer use事例]
まずはLv.1。送信直前で止める。
いきなりBlenderや業務システムを渡す必要はありません。テスト用Webフォームへ値を入力し、送信ボタンの直前で止め、画面と入力内容を確認するだけでも、観察・操作・検証の一周を体験できます。
Lv.1 / テスト用Webフォーム
テスト用Webフォームだけを対象にしてください。
入力欄の現在値と、これから入力する項目を最初に一覧で報告してください。
値を入力したら送信ボタンは押さず、スクリーンショットを返して停止してください。
入力ミス、画面遷移、未入力項目がないかを確認できる状態にしてください。
安全に試す手順は、操作より先に決める。
- 対象を限定する。テスト用アカウント、複製したファイル、許可したサイトとアプリだけを使います。
- 最初は観察させる。画面の状態、変更対象、次に行う操作を短く報告させ、実行前に範囲をそろえます。
- 数操作ごとに確認する。スクリーンショットとアプリの実際の状態を返し、座標ずれや画面遷移の失敗を早く見つけます。
- 戻せない操作は人が承認する。送信、購入、公開、削除、権限変更、機密情報の入力は停止点にします。
- 結果を外部から検証する。「完了しました」という返答だけでなく、ファイル、レコード、テスト結果、画面の変化を確認します。
Lv.3 / Blenderプロジェクト
テスト用のBlenderプロジェクトだけを対象にしてください。
最初に現在の画面と、変更するファイル・オブジェクトを確認して報告してください。
変更は複製ファイルへ行い、3操作以内にスクリーンショットを返して状態を確認します。
削除、上書き保存、外部送信、ログイン、購入、公開は実行せず、必要なら私に確認してください。
最後に、変更した項目、保存先、レンダー結果、未確認の点を一覧で返してください。本番で使うときは、隔離環境、許可リスト、重要操作の確認、ステップ数・時間・費用の上限、実際の結果の検証を先に決めます。画面上の指示は未信頼データとして扱い、誤クリックで権限や送信範囲が広がらないようにします。[安全な実行の指針]
04 / LONG-HORIZON GAMEPLAY
GPT-6 Astraは、ポケモンFireRedを18時間12分で殿堂入り。
公開された比較記録では、GPT-6 Astra(high)がポケモンFireRedを18時間12分で殿堂入りまで進めました。GPT-5.6 Sol(max)は約96時間35分、GPT-5.5は218時間を超えても未完と報告されています。Astraの記録は、同じ実験プロジェクトによるコミュニティ投稿であり、OpenAIが実施した公式ベンチマークではありません。[投稿者の比較記録] [Astraの公開スレッド]
比較に使われたのは、Codexとエミュレーターを組み合わせたvision-onlyハーネスです。ゲーム画面をスクリーンショットでAstraへ渡し、Astraが次の入力を決め、その入力をハーネスがエミュレーターへ返します。完全なRAM状態は読み出さず、画面の前後にプレイヤー座標とマップIDだけを補助情報として使います。したがって「生のスクリーンショットだけ」とまでは言えませんが、攻略APIを直接呼ぶボットではなく、画面を見て長い目的へ進むcomputer useに近い設定です。[Solの同条件スレッド] [ハーネスの実装]
| モデル | ゲーム・条件 | 結果 | 所要時間 |
|---|---|---|---|
| GPT-6 Astra (high) | FireRed / vision-only | 殿堂入り | 18時間12分 |
| GPT-5.6 Sol (max) | FireRed / vision-only | 殿堂入り | 約96時間35分 |
| GPT-5.5 | FireRed / vision-only | 218時間超で未完 | 完了記録なし |
| Gemini 2.5 Pro | Blue / fixed autonomous harness | 殿堂入り | 406.5時間 |
| Claude 3.7 Sonnet | Red / memory・pixel・function calls | 3バッジ | 公式発表時点で未完 |
Astraの18時間12分は、同じFireRedのvision-only条件でSolが要した約96時間半の5分の1ほどです。Gemini 2.5 Proは、Googleの技術報告書でBlueを固定ハーネスの完全自律Run 2として406.5時間で殿堂入りさせましたが、RAMから変換したテキスト、経路探索、岩押しパズル用の補助ツールを使っています。Claude 3.7 Sonnetは、画面入力・メモリ・関数呼び出しで3つのジムバッジまで進みました。Anthropicの現行Fable 5.1は長時間エージェントを主用途にしていますが、同じFireRed条件の殿堂入り時間を公式には公表していないため、この表では比較可能なClaude 3.7の公式実験を載せています。モデルの世代だけでなく、ゲーム、入力方法、補助ツール、試行回数が違うため、単純な世界ランキングにはできません。[Gemini 2.5技術報告書] [Claude 3.7の公式報告] [Claude Fable 5.1の用途]
| 観点 | 公開実験で確認できること | 自分で試すときの記録 |
|---|---|---|
| 観察 | 画面の前後をスクリーンショットで渡す | 解像度、頻度、座標オーバーレイの有無 |
| 状態 | RAMは最小限の座標・マップIDに限定する説明 | 何をモデルへ渡し、何を隠したか |
| 操作 | モデルの判断をハーネスがボタン入力へ変換 | 連打上限、入力遅延、停止・キャンセル方法 |
| 完了 | 配信や投稿でクリアを報告 | 殿堂入り画面、セーブデータ、介入ログ |
この題材が面白いのは、一手の正解よりも、何時間も目的を保つ必要がある点です。道を覚える、戦闘の結果を読む、回復や交代を判断する、経験値を稼ぐ、次の町へ向かう。失敗したあとに、同じ場所で同じ入力を繰り返さずに立て直せるかが問われます。これはARC-AGI-3の探索・計画と共通する部分がありますが、ポケモンはルールが既知で、ゲーム内の状態も限定された課題です。ここからAGIや人間同等の汎用性を結論づけることはできません。
試すなら、最初から「殿堂入り」まで走らせない。
完全自律プレイは、長時間・高コスト・失敗原因の切り分けの難しさが重なります。まずは、町からポケモンセンターまで移動する、決めた相手との一戦に勝つ、メニューから回復して戻る、といった短い区間を同じ条件で3回試します。成功率、無限ループ、誤入力、状態の取り違えを記録できてから、区間をつなぎます。
貼り付け用 / 自律プレイの実験条件
合法的に入手したゲームと、テスト用エミュレーターだけを対象にしてください。
目的は「指定した区間を、プレイ中の人間入力なしで完了すること」です。

自律条件:
- 攻略サイト、RAMの完全なゲーム状態、外部の手動入力は使わない
- 各操作の前後にスクリーンショットを取得する
- 画面から判断した状態、次の目的、入力、結果をログに残す
- 同じ入力を3回繰り返して変化がなければ停止する
- ループ、クラッシュ、セーブ失敗、判断不能は人に報告して停止する

完了条件:指定区間の終了画面、操作ログ、失敗回数、未確認事項を返す。
ゲームの外部送信や公開、セーブデータの削除は実行前に確認してください。
公開実験の詳細は、投稿者の説明と配信に依存しています。使用したハーネス、入力遅延、全操作ログ、総トークン量、途中の人間介入を第三者が統一条件で監査した公式結果ではありません。記事では「Astraがポケモンを完全攻略した」という確定的な性能値ではなく、長期computer useを考えるための実例として扱います。ゲームソフト、ROM、エミュレーターの利用は各サービスと権利者の規約に従ってください。
05 / THE BENCHMARK
ARC-AGI-3の99.9%を、仕事でどう読むか。
説明書のない小さなゲームを渡され、触った結果からルールとゴールを推測して進む。ARC-AGI-3は、こうした未知の環境での学び方を測る試験です。以前のARC-AGI-1・2とは異なり、操作しながら解く形式になっています。[ARC Prizeの試験解説]
ARC PrizeによるAstraの検証には、二つのハーネスが登場します。ハーネスは、AIへ観察結果を渡し、操作を実行し、途中の状態を引き継ぐ周辺の仕組みです。
Standard
各社を共通の最小構成で比べる環境。AIが自分で残すメモを選び、次の操作へ引き継ぎます。
Provider Adapter
提供元の機能を使う環境。外から読めない推論状態を保持し、長い会話を圧縮して作業を続けます。
| ハーネス | 推論設定 | スコア | 評価実行の費用 |
|---|---|---|---|
| Standard | high | 54.8% | $40,705 |
| Standard | max | 62.7% | $26,098 |
| Provider Adapter | high | 99.9% | $18,817 |
high・maxは、AIにどれだけ推論させるかの設定です。費用はこの評価実行について報告された額で、1問や月額の料金ではありません。結果ページでは小数第2位まで表示されますが、ここでは解説記事の丸め方に合わせています。自分の仕事で再現するなら、モデルだけでなく、状態を保存して次の工程へ渡す仕組みも同時に設計します。[解説] [詳細結果]
「標準環境の最高値62.7%」と「Adapterの99.9%」は推論設定も異なります。同じhighで見ると54.8%と99.9%。同じモデルでも、途中の考察を使い直せる構成で結果が大きく変わっています。
さらにAdapterのmaxでは、96%のレベルで、クリアした人の操作回数の中央値より少ない操作で進めたと報告されています。ここで比べているのは操作の効率です。所要時間や費用まで人間と同じになった、という意味にはなりません。[ARC Prizeの検証]
実務でAstraを試すなら、資料やログを入力し、判断の理由、未解決点、次の担当を記録させてください。ARC-AGI-3の結果から導けるのは、モデル名だけでなく、状態を次の工程へ渡す設計を評価するということです。これは評価結果からの筆者の解釈で、同じ改善率が実務で出るという予測ではありません。
06 / WHERE TO USE IT
Astraを使う仕事、Lunaで足りる仕事を分ける。
モデル名で決めず、仕事の途中で判断が変わるか、完成を外部から確認できるかで選びます。以下は、公式の能力と評価を踏まえた使い方の提案で、この組み合わせの速度や成功率を実測した事例ではありません。
複数の原因が考えられる不具合調査
再現条件、ログ、関係するコードを渡し、仮説を比べ、修正と確認まで依頼します。完成物は原因の説明、差分、検証結果。ログの収集や明確な再現手順の実行は、別の担当に切り出せます。
食い違う資料から、判断できる比較表を作る
複数サービスの仕様書から、採用条件に合う候補を絞る場面です。資料ごとの事実収集を分担し、Astraは条件の違いや矛盾を点検します。完成物には、推奨理由と未確認事項を残します。
手作業の手順を、小さな道具へ変える
CSVの集計から報告書作成まで、今の手順とサンプルを渡します。Astraに例外処理と完成条件を整理させ、試作品を作らせる。人は元データとの照合と、業務上の判断を確認します。
Astraがなくても進む仕事
- 文章の言い換え
- 定型JSONの生成
- 単純な項目抽出・分類
- 小さいコード修正
- 正解と手順が明確な作業
Astraで差が出やすい仕事
- 原因がまだ分からない
- 複数の情報が食い違っている
- 複数ツールをまたぐ
- 途中結果で次の行動を変える
- 作業分解や完了条件の設計が難しい
短い文章の整形、決まった項目の抽出、単純な分類は、まずLunaで十分かを確かめやすい仕事です。複数の資料を読んで判断する中間の仕事にはTerraやSolも候補になります。迷ったら、同じ入力で「完了までの時間」「人が直した回数」「確認にかかった時間」を一度測り、その記録で切り替えます。[公式のモデル選択案内]
07 / ORCHESTRATION
Astraに設計とレビュー、Lunaに定型作業を任せる。
オーケストレーターは、仕事を分け、担当へ依頼し、戻った結果を一つにまとめる進行役です。サブエージェントは、その一部分を受け持つ別のAI担当です。Astraを進行役にし、GPT-5.6 Lunaへ「資料Aから料金だけを抽出する」のような完了条件の明確な作業を渡すと、分担の効果を測りやすくなります。
正式なモデルIDはgpt-6-astraとgpt-5.6-lunaです。OpenAIのAstra向けガイドは分担のタイミングを指示する方法を案内し、サブエージェントの公式ガイドは、Lunaを範囲が狭く明確な反復作業向けに位置づけています。この二つを組み合わせる担当設計は、本記事の提案です。[Astraガイド] [サブエージェントガイド]
はい → Luna
定型抽出・分類・小さな修正
いいえ → Terra / Sol
実装・調査・レビュー
はい → Astra
目的・分解・統合・検証
いいえ → Terra / Sol
まず手順を明確にする
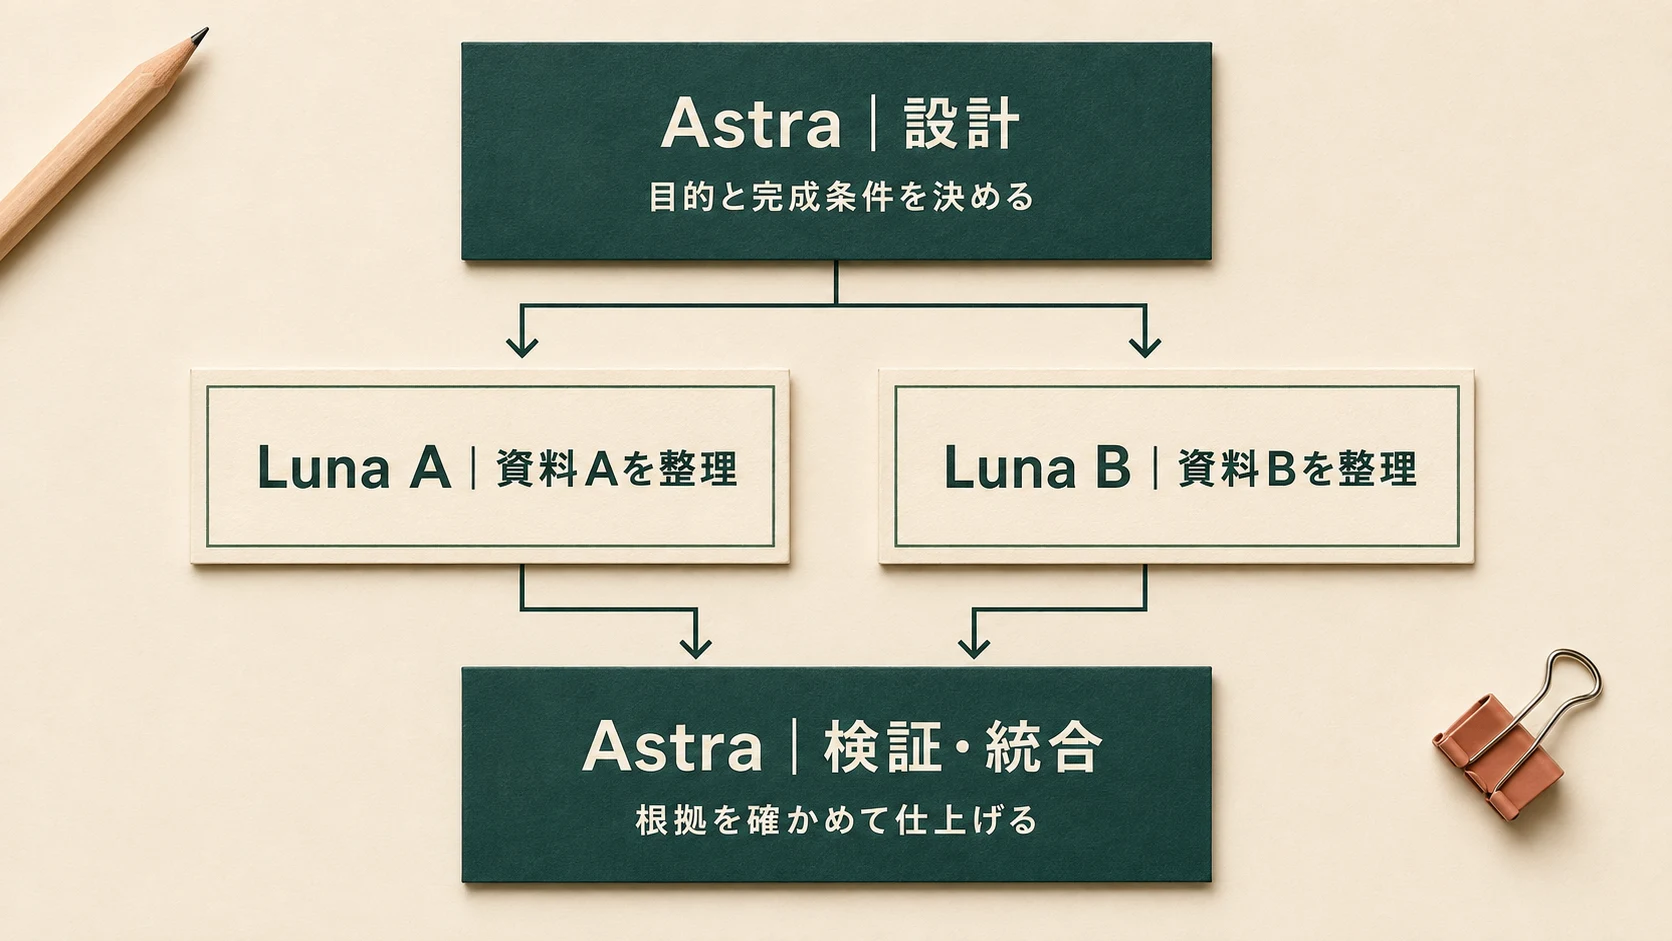
| 担当 | 渡す仕事 | 戻してほしいもの |
|---|---|---|
| Astra | 目的、比較軸、採用条件を決める | 評価基準と各担当への依頼 |
| Luna A | 指定資料Aから料金・制限を抽出 | 項目、条件、出典位置、未確認点 |
| Luna B | 指定資料Bから同じ項目を抽出 | 同じ形式の結果 |
| Astra | 証拠を照合し、条件差と矛盾を解消 | 比較表、推奨理由、残る疑問 |
分担するのは、同時に進められる仕事です。まだ仕様が決まっていないのに、画面と裏側の処理を別々に作らせると、後で前提が食い違います。まずAstraが共通の仕様を固め、その後に独立した作業へ分けます。
Lunaには、結果をすぐ合否判定できる仕事を渡す。
「このサービスを全部調べて」では、Lunaも調査方針から判断することになります。「この資料から、月額、上限、超過料金を、出典の節名付きで抽出して」なら、作業と確認の範囲が明確です。見つからなかった項目は、不明として戻させます。
渡す情報は、目的、対象資料、制約、完了条件、返答形式。元の会話を丸ごと複製するより、仕事に必要な資料を絞り、出典をたどれる形で渡すのが出発点です。ただし、前提まで削って短くすると逆効果になります。
難しい判断が残ったらAstraへ戻すか、Terra・Solで再検討します。細かい文言の修正一つなら、担当を増やさず単独で終えるほうが速い場合もあります。
08 / TRY THIS
Astra単独か、Lunaへの分担かを依頼文で指定する。
まず利用中のモデル選択でAstraを選び、以下の依頼文を、資料と一緒に渡します。本文でモデル名を名乗らせるだけでは、実際のモデルは切り替わりません。Astraを選べること、サブエージェント機能とLunaを利用できることが前提です。
公式ガイドでは、子のモデル設定を省くと親のモデルを引き継ぐと説明されています。「サブエージェントを使って」だけでは、Lunaへ任せたことにはなりません。担当モデルを明示し、実行時に表示されるエージェント情報でも確認します。[モデル指定と分担の仕様]
依頼文は、目的・完了条件・担当・検証・停止点で書く。
目的:
完成条件:
対象:
制約:最初に仕事を分解してください。
判断が必要な部分はあなたが担当してください。独立していて、完了条件が明確な作業だけ
gpt-5.6-lunaへ委譲してください。結果を元資料・テスト・実データで
確認してください。公開・送信・削除・本番変更は
実行前に確認してください。貼り付け用 / 資料比較の例
目的:添付したサービスA・Bの資料から、導入判断用の比較表を作る。
完成条件:料金・利用上限・必要な連携・データの扱いを、出典付きで比べる。

あなたは進行役として、最初に比較軸と未確認事項を整理してください。
独立して調べられる資料の抽出作業には、gpt-5.6-luna の
サブエージェントを使ってください。同時実行は最大2つにします。
Lunaを指定できない場合は、別モデルで始める前に知らせてください。

各担当に渡すもの:対象資料、抽出項目、制約、完成条件。
各担当から受け取るもの:事実、出典URLまたはページ・節名、
適用条件、不明点。推測で穴を埋めないでください。

あなたは戻った結果を原典と照合し、条件の違いと矛盾を整理して、
比較表・推奨理由・追加確認が必要な項目を仕上げてください。
判断が難しい項目は、あなた自身で再検討してください。
外部への送信や契約は行わず、比較資料の完成まで進めてください。
最初はAstraをhigh、Lunaをmediumで試す、という設定も一案です。これは最適値の実測結果ではありません。簡単な抽出なら低い設定へ、複雑な判断なら高い設定へ変え、同じ仕事で確認します。APIの推論設定とアプリ側のUltraなどの実行モードは、同じものとして扱わないようにします。
単独で任せるときも、修正と検証までを終点にする。
この不具合の再現条件を確認し、原因の仮説を検証して、
必要最小限の修正と、その修正を確かめるテストまで進めてください。
最終報告には、原因・変更箇所・実際の検証結果・残る不確実性を含めてください。
本番データの変更や公開は、別途確認してください。
「どう直せばいい?」から「修正して検証結果を返して」へ。求める終点を明確にすると、Astraを相談相手から作業担当へ移しやすくなります。
09 / COST & FIRST RUN
Astraは高価。1件の成果物でLuna分担の効果を比べる。
APIは、プログラムからモデルを呼ぶための窓口です。API料金は主に、入出力する文章の量を数えるトークンという単位で計算されます。
| モデル | 入力 | 出力 |
|---|---|---|
| GPT-6 Astra | $10 | $50 |
| GPT-5.6 Luna | $0.20 | $1.20 |
キャッシュを使わず、入力272K以下の場合。272Kを超えるとリクエスト全体の入力は2倍、出力は1.5倍になります。キャッシュ、推論トークン、ツール、Fastなどの処理モードも費用に影響します。ChatGPT・Codexの契約枠やクレジット消費を、この表から直接換算することはできません。[Astra料金] [Luna料金]
同じ量を処理するなら、Lunaの単価は入力でAstraの50分の1、出力で約42分の1です。ただし親の説明、子の返答、最終レビューも課金対象になります。担当を増やしただけで、この比率のまま安くなるわけではありません。
計算例:同じ量なら、どれくらい違う?
仮に、入力1万・課金対象の出力2千トークンを処理すると、Astraは$0.20、Lunaは$0.0044です。キャッシュとツール料金を除いた、同じトークン数での算数です。
Lunaの作業を2本動かし、それぞれが1万入力・2千出力、Astra側も同じ量を使ったと仮定すると、合計は$0.2088。実際にはトークン量もやり直し回数も変わるため、この例は節約実績ではありません。
Astra+Lunaの構成が有利なのは、安く切り出せる作業が十分にあり、統合の手間が小さい場合です。合否を判定しにくい仕事を大量に渡すと、最後にAstraと人間が全部読み直すことになりかねません。
最初の1件で、Astra単独と分担を比べる。
- 繰り返す仕事を一つ選ぶ。公開資料の比較や、戻せる小さなコード修正から始めます。
- 入力と完成条件をそろえる。Astra単独とAstra+Lunaに、同じ資料・ツール・権限を渡します。
- 完成品を同じ基準で確認する。正しさ、完了時間、総費用、やり直し、人の確認時間を記録します。同種タスクを3回程度試すと、1回だけの偶然を減らせます。
- 分担に意味がある部分だけ残す。速くならない、誤りが増える、確認が重い担当は減らします。
| 指標 | Astra単独 | Astra+Luna |
|---|---|---|
| 完了したか | ||
| 所要時間 | ||
| 総コスト | ||
| 人間の修正回数 | ||
| 人間の確認時間 | ||
| 誤り | ||
| 最終成果物の品質 |
今日試すなら、毎週作っている比較表から1件選びましょう。Astraに完成条件と比較軸を渡し、Lunaには資料ごとの項目抽出を任せる。最後に元資料と見比べて、人が直した箇所と確認時間を数える。その記録で、次もこの組み合わせを使うかを決めます。
「Astraを使ってみる」ではなく、今のモデルで途中で詰まる仕事を一つ選ぶ。その仕事を同じ条件で比較し、次に使うモデルを自分の記録から決めるのが最短ルートです。