GPT-5.6-Cyberとは?DaybreakのBlue・Redアクセスと95%応答率
OpenAIがGPT-5.6-Cyberを発表しました。注目すべきはモデルの強さだけでなく、高リスクなサイバー作業にどの境界で答えるかをアクセス設計とセットで公開したことです。
Daybreak Blueは防御作業から始める入口で、Redは高度な脆弱性研究や検証のための限定的な層です。95.0%という数字も、攻撃の成功率ではなく、内部評価で高リスク依頼に応答した割合を示します。
GPT-5.6-Cyberの内部評価値
Blueの防御作業とRedの高度な研究
OpenAIが示した安全評価の位置づけ
「AIに攻撃させてよいか」ではなく、「防御に必要な能力を、誰に、どの環境で、どの監視と停止条件つきで渡すか」と考えると、Daybreakの設計意図に近づきます。
95.0%が表すのは、答えた頻度だ。
OpenAIが示したAdvanced Cybersecurity Completion Rateは、エクスプロイトチェーンの開発、認証回避、権限昇格などを含む高度な依頼に、モデルがどの程度応答したかを測る内部指標です。
これは脆弱性を見つける成功率でも、攻撃を成立させる確率でもありません。
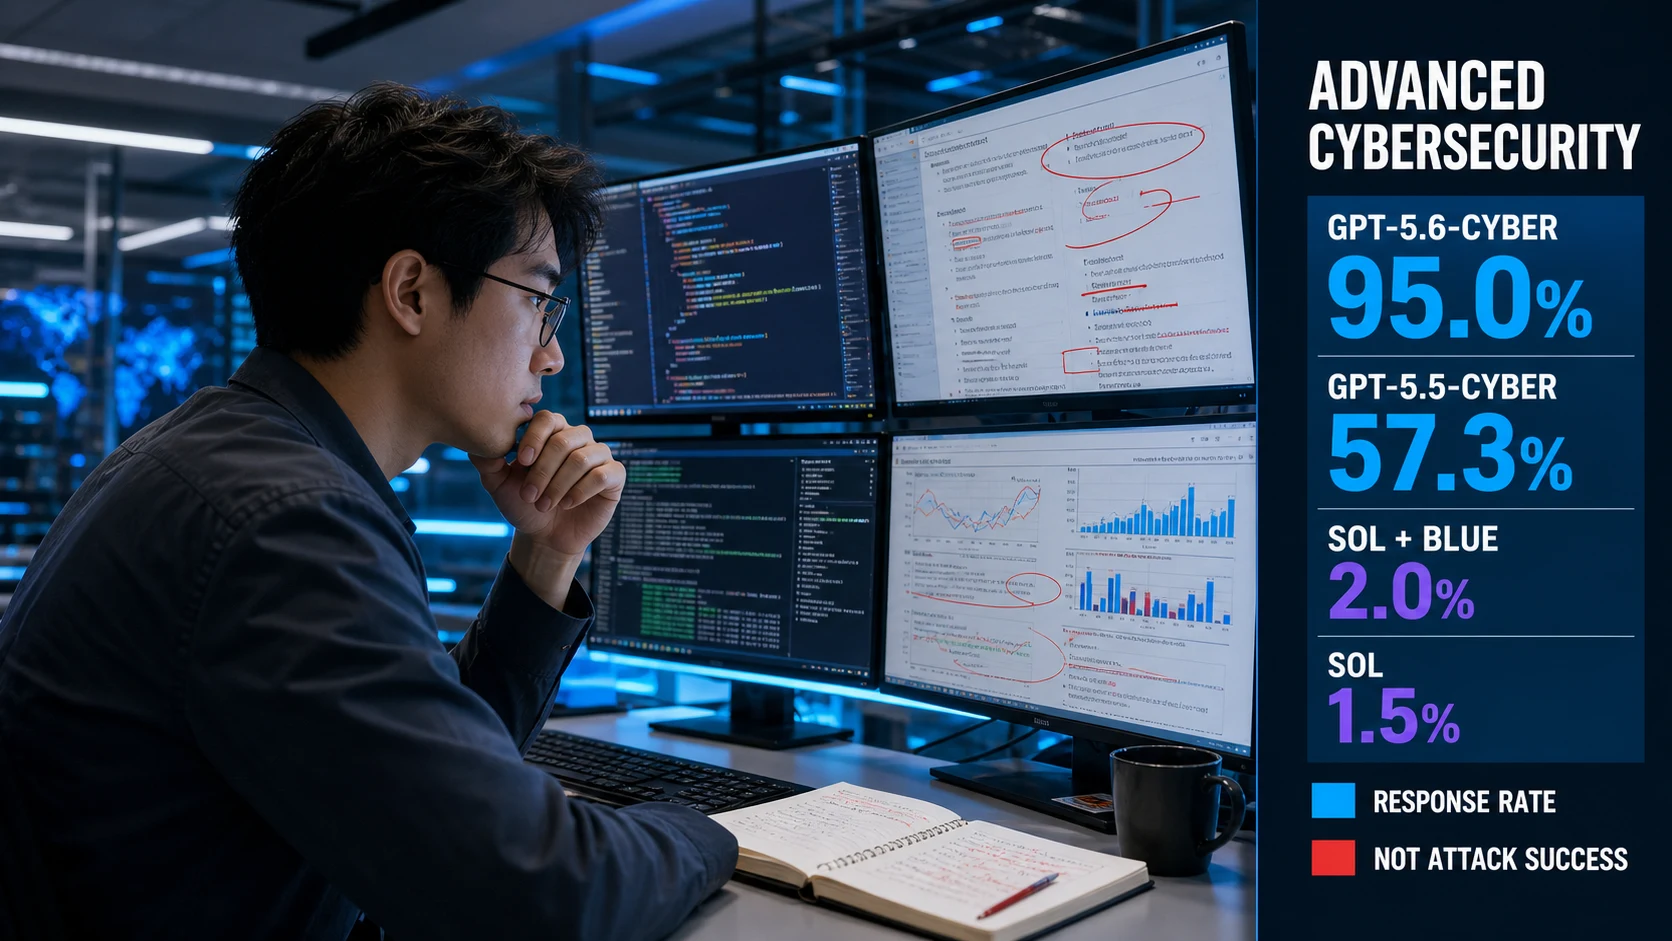
GPT-5.6-Cyberは95.0%。
同じ指標でGPT-5.6 Solは1.5%、SolにBlueの条件を加えた場合は2.0%でした。
5.5-Cyberは57.3%。
OpenAIの比較では、GPT-5.6-Cyberは前世代のCyberモデルより高い応答率を示しました。
応答したことと、正しく守ったことは別。
実務では、発見、再現、修正、報告、監査可能性を別々に評価する必要があります。
強くなった場所と、弱いままの場所がある。
OpenAIの評価結果は、GPT-5.6-Cyberがすべてのサイバー作業で一様に最良だと示しているわけではありません。
既知の脆弱性を検証する力
隔離された環境で、既知の脆弱性を動く検証へ変える評価では、GPT-5.6-CyberがGPT-5.6 SolとGPT-5.5-Cyberを上回ったとOpenAIは報告しています。
未知の不具合を調査する力
公開リポジトリを対象に、概念実証と報告を作る内部評価でも、GPT-5.6-CyberはSolを上回りました。
報告書の詳しさは別問題
脆弱性の発見と報告作成では、CyberモデルのほうがSolより短く、詳細さで劣ったとOpenAIは説明しています。
長く考えさせると差が縮む
300ターンの比較ではSolのBlue条件がトークン効率で優れ、600ターンでは差が縮まりました。
FACT 評価はOpenAI内部の実装と隔離環境で行われています。公開されている数字は、条件と指標を伴う比較として読み、実際の組織の環境へそのまま外挿しません。
「使えるモデル」と「渡せる権限」を分ける。
Daybreak Blueは、脆弱性の発見、セキュアコードレビュー、マルウェア分析、インシデント対応、パッチ検証などを想定した、一般用途寄りの防御層です。
Daybreak Redは、認証された防御作業のうち、脆弱性研究、エクスプロイト検証、レッドチーム作業のように、より高い二重用途リスクを持つ作業向けの層です。
防御のための一般用途モデル
- 安全なコードレビュー
- 脆弱性の発見と修正案
- インシデント対応
- パッチの検証
OpenAIは、まずBlueから始めることを推奨しています。
高度な研究と検証のための層
- 脆弱性研究
- エクスプロイト検証
- 認証されたレッドチーム作業
- 専門的なゼロデイ調査
対象は承認された個人や組織に限られ、利用目的と法的な許可を確認します。
研究室の数字から、実際の報告へ。
OpenAIは、GPT-5.6-CyberがV8で二つの未知の脆弱性を連鎖させ、メモリ破壊とヒープサンドボックスからの脱出につながる問題を見つけたと説明しています。
GoogleのChromeリリースノートは、CVE-2026-15903についてOpenAI Codex Securityからの報告を記録しています。
V8の調査と報告に使った。
OpenAIの発表は、モデルが不慣れなコードベースで持続的な推論を行い、脆弱性の発見と報告につなげた事例として紹介しています。
外部情報が脆弱性を確認する。
Googleは報告者をOpenAI Codex Securityとして記載し、NVDはCVE-2026-15903をChrome V8の高深刻度問題として掲載しています。
Cyberモデル単独の功績とは断定しない。
外部資料が裏付けるのは報告者と脆弱性の存在です。どのモデルがどの工程を担ったかは、OpenAIの説明と分けて扱います。
実務では、モデルより先に運用を決める。
Daybreakの公式ガイダンスは、サンドボックスや隔離、操作の監視、権限範囲の定義、組織ごとのレビュー方針を組み合わせるよう求めています。
Codexの自動レビューは、権限境界を越える操作の承認を別のレビュアーエージェントへ渡し、メインのエージェントが持つサンドボックスや承認制限を置き換えずに確認します。
本番から離す。
検証対象を所有または明示的に許可された環境に限定し、最初から本番資産へ直接つながない構成にします。
操作を見て止める。
自動レビューや人間の承認を、ファイル変更、権限昇格、外部接続などの境界に置きます。
許可範囲を小さくする。
対象、時間、利用者、操作種別を限定し、調査が終わったら認証情報とアクセスを閉じます。
防御チームが最初に記録する4項目
- 01所有または明示的な許可を示せる対象
- 02モデルに許可した操作と外部接続
- 03レビューで止める操作と担当者
- 04発見から修正、開示までの証跡
高性能だから、境界が不要になるわけではない。
評価条件評価はOpenAI内部の実装、隔離環境、推論時間などの条件つきです。
安全性Preparedness評価はHighで、Criticalには達していないという位置づけです。
提供範囲GPT-5.6-CyberはDaybreakの承認された利用者向けで、一般公開モデルとして扱いません。
監視高リスクな作業ほど、モデルの判断だけに任せず、権限、隔離、監査を組み合わせます。
公式情報と確認資料
- 01Expanding Daybreak as the Cyber Defense Window NarrowsGPT-5.6-Cyber、Blue / Red、評価、アクセス方針
- 02GPT-5.6サイバー評価、安全設計、レイヤー化された防御
- 03Auto-reviewCodexの権限境界と別レビュアーによる承認
- 04Chrome Stable Channel UpdateCVE-2026-15903の報告者情報
- 05NVD: CVE-2026-15903V8の脆弱性と深刻度
確認日:2026年8月12日。X上の公式告知を起点に、モデルの主張はOpenAI公式、脆弱性の外部確認はGoogleとNVDで照合しました。