OPERATING MODEL / AI CODING AGENTS
Vibe Coding時代の
マルチタスクとの向き合い方
まず一つの主問題を決め、10分で境界を書き、独立した作業だけをAgentへ渡す。人間の注意を散らさずにAIの実行量を増やすための実践ガイドです。
今いちばん重要な問題を一つ選び、判断の軸を固定する。
独立した方向の調査、実装、検証を同時に走らせる。
「終わった」という通知を、注意を奪う割り込みからキューへ変える。
THE ACTION
迷ったら、この順番だけ守る。- 01問いを一つにする
「何を直すか」ではなく「何を決めたいか」を書く。
- 02Agentを2つまで動かす
実装と評価など、成果物がぶつからない組み合わせにする。
- 03レビュー枠を先に取る
30分後に10分だけ、成果物をまとめて見る時間を確保する。
- 04詰まったら増やさない
未レビューが残る間は、新しいタスクを委任しない。
THE NEW BOTTLENECK
AIの速度が上がるほど、割り込みが高くつく
AIコーディングエージェントが一つの作業を終えるまで待つ時間は、短くなりました。だから人は、次のAgentを起動し、別のブランチを作り、別の課題を同時に進めたくなります。
しかし、Agentが速くなっても、人間の注意、判断、レビューの帯域は同じ速さでは増えません。タスクをたくさん投げること自体が問題なのではなく、完了するたびに人間が文脈を切り替え、採否を決め、統合まで考え始めることが負荷になります。
FACT / OPENAI
複数Agentの実行環境は、すでに現実の選択肢になっている。OpenAIはCodex appについて、複数のAgentを別々のスレッドで並列に動かし、worktreeで同じリポジトリの作業を隔離できると説明しています。発表が示すのは「人が同時に考えられる」ということではなく、監督と協働が新しい開発課題になるという変化です。
OpenAIの発表を読む ↗FACT / ANTHROPIC
長い作業ほど、セッションをまたぐ引き継ぎが必要になる。Anthropicは、長時間のAgent作業ではコンテキストが失われるため、初期化、進捗ファイル、段階的な実装、Git履歴、テストを組み合わせる方法を紹介しています。タスクを小さな検証可能な単位へ分けることは、速度のためだけでなく、再開可能性のためでもあります。
Anthropicの実践知を読む ↗INTERPRETATION AI時代のボトルネックは、実装の待ち時間から、判断の待ち行列へ移っています。増やすべきなのはAgentの数ではなく、Agentの結果を人間が無理なく処理できる設計です。
CONTEXT / OLDER OBSERVATION
Microsoft Researchの2005年の観察研究では、開発者がコードの理由を思い出すために時間を使い、タスク切り替えや別の場所への変更が頻繁な負担として現れました。古い調査なのでAIエージェントの効果を直接証明するものではありませんが、人間の文脈切り替えを無料とみなさないための背景になります。
研究概要を読む ↗OPERATING MODEL
人間の思考は絞り、Agentの実行だけ広げる
この運用を一行で表すなら、Human-Serial / Agent-Parallelです。人間は「何を解くか」「どれを採用するか」「いつ出すか」を直列に扱い、Agentはその枠内で「どう調べるか」「どう実装するか」「どう検証するか」を並列に試します。
たとえば認証機能を「調査」「実装」「テスト」「UI」の4つに分けて同時に進めるとき、4人のAgentに同じ曖昧な課題を投げるだけでは、方針が4つに割れます。一つの主問題と共通の受け入れ条件を渡し、独立した方向だけを分けると、並列化の効果が出ます。
RECOMMENDATION 「何個のAgentを動かすか」ではなく、「人間が同時に抱える判断は一つか」を先に確認してください。判断が二つ以上あるなら、まず問題を分けるか、優先順位を決めます。
AUTONOMY GATE
並列化するかは、作業名ではなく判断密度で決める
「調査だから並列」「実装だから直列」という分類は、すぐに破綻します。同じ調査でも、結論が一つに収束する探索は並列化しやすく、顧客要件の解釈が必要な調査は人間の判断が先に要ります。
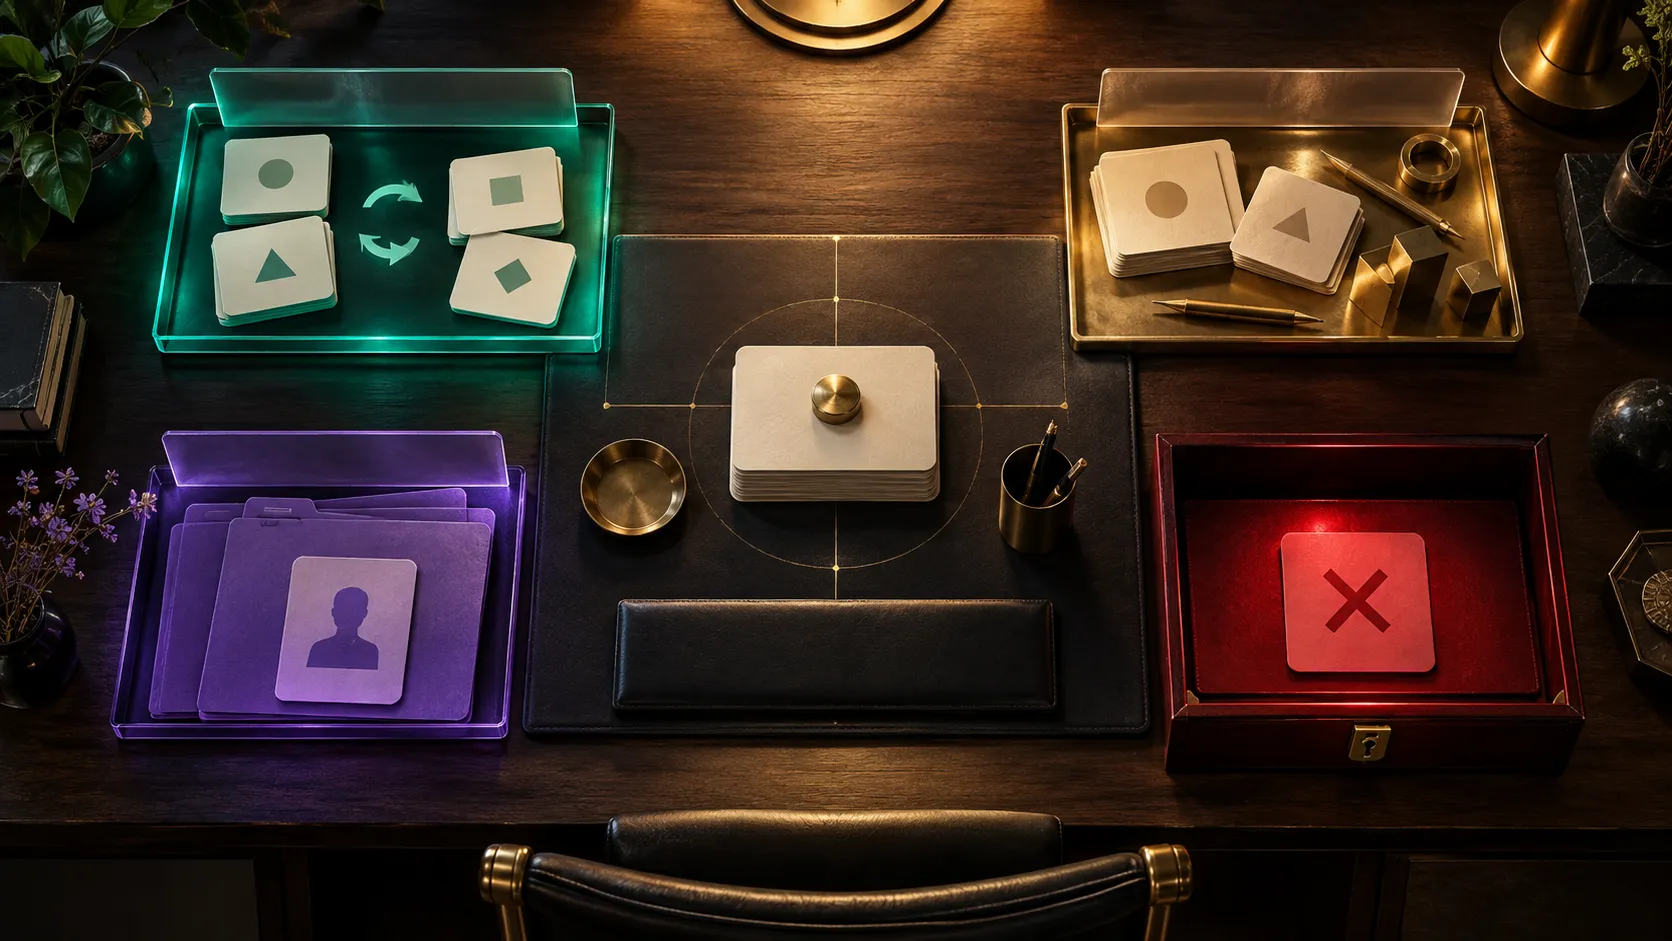
ACTIVELY PARALLELIZE
今、広げる
目的と完了条件が明確で、成果物が独立しており、機械的に検証できるもの。
- 複数案の調査
- 局所的な実装
- テストケースの作成
SHAPE THEN DELEGATE
形を整えてから渡す
境界や選択肢が曖昧だが、問題を小さくすればAgentへ渡せるもの。
- 仕様のたたき台
- 既存コードの移行
- UIの複数案
KEEP HUMAN-SERIAL
人が順番に決める
目的、優先順位、責任範囲を決める必要があり、結果が次の問いを変えるもの。
- 本番リリースの判断
- 認証・権限の設計
- 顧客との要件合意
POSTPONE OR DROP
いったん止める
検証方法がなく、他の決定を待ち、戻すコストも高いもの。
- 目的が未定義の改善
- 証拠のない最適化
- 統合先がない作業
| ゲート | 問い | 並列化しやすい状態 |
|---|---|---|
| Goal | 何を良くする作業か | 一文で言える |
| Decision density | 途中で人が決めることは多いか | 例外が少なく、境界を先に書ける |
| Verification | 完了を何で確かめるか | テスト、差分、画面など証拠がある |
| Coupling | 他の作業にどれだけ依存するか | 入出力が分離している |
| Reversibility | 失敗したら戻せるか | 小さな差分で、ロールバックが明確 |
| Review compression | 人がまとめて確認できるか | 同じ形式の成果物として返る |
判断の目安:6つのうちGoal・Verification・Reversibilityが書けないなら、Agentを増やす前にタスクを整えます。全部が揃う必要はありませんが、分からないものを「並列だから速い」で押し流さないことが重要です。
EIGHT OPERATING RULES
運用は8つで十分
複雑なオーケストレーションを先に作ると、運用そのものが新しい仕事になります。まずは、人間の注意を守るための最小ルールだけを決めます。
Human Deep Workは一つ
人が深く考える主問題を同時に増やさない。Agentを増やす上限は、起動数ではなくレビュー能力で決める。
Agent WIPは可変
動かしてよい数は、未レビューの成果物が増えすぎない範囲で調整する。常に最大数を埋めない。
依頼に4点を書く
Goal、Scope、Non-goals、Acceptance Criteriaを先に置く。長い指示より、判断できる境界が効く。
停止条件を明示する
曖昧な要件、破壊的操作、権限変更、テスト不能、想定外の依存に出会ったら止まり、質問を返す。
完了はレビューではない
完了通知を見た瞬間に作業を切り替えない。成果物をキューへ置き、決めたチェックポイントでまとめて見る。
実装と評価を分ける
Implementer、Evaluator、Tests、Browser verificationの役割を分けると、自己評価だけに依存しにくい。
レビュー可能な要約を返す
差分、検証、判断待ち、残るリスクを定型フォーマットで返す。人にログの発掘作業をさせない。
統合は直列に寄せる
mainへの反映、移行、リリース、顧客影響のある変更は、最後に一つの判断として扱う。
THE DELEGATION CONTRACT
依頼を会話から、レビューできる契約に変える
Agentへの依頼は、丁寧な会話である必要はありません。あとで別の人が読んでも、何をもって完了としたか分かる契約であれば十分です。
DELEGATION CONTRACT
Goal:
Context:
Scope:
Non-goals:
Constraints:
Acceptance Criteria:
Verification:
Escalate only if:
Output Contract:
REVIEW PACKET
Outcome:       何が変わったか
Changed:       主要な差分
Verified:      実行した確認
Decisions:     採用した判断
Risk:          残るリスク
Human action:  人に必要な決定
A BETTER TASK
Goal: ログイン画面のローディング状態を、既存のボタン規約に合わせて改善する。
Non-goals: 認証フロー、API、デザインシステムの変更はしない。
Verification: 既存テスト、キーボード操作、モバイル幅の画面確認。意図しないファイル変更がないこと。
Escalate only if: 既存の認証状態に触れる必要がある、または受け入れ条件を満たせない。
RECOMMENDATION 良い依頼は、Agentを賢く見せるためではなく、戻ってきた成果物を人が短時間で判定するために書きます。出力の形式まで指定すると、レビューの圧縮率が上がります。
QUEUE-BASED WORKFLOW
「完了しました」を、割り込みからキューへ変える
レビューのタイミングを固定のタイマーで決める必要はありません。重要なのは、通知が来たから見るのではなく、状態がレビュー可能になったら見ることです。
PUSH / FRAGILE
完了するたびに割り込む
文脈の復元、差分の確認、次の判断が小刻みに発生する。Agentの実行時間が短いほど、割り込み密度が上がる。
PULL / STABLE
レビュー可能な状態をまとめて取る
各Agentは先に進み、人はキューから同じ形式の成果物をまとめて取る。レビュー容量が埋まったら、新しい作業の委任を止める。
EXAMPLE / UI CHANGE
一つの小さなUI改善を、仕様・実装・評価に分ける。
- 00:00Human / 10 min
画面、非対象、受け入れ条件を決める。
- 00:10Agent A / implement
限定された範囲を実装し、テストと差分を返す。
- 00:10Agent B / evaluate
別視点でアクセシビリティ、レスポンシブ、回帰を確認する。
- 00:25Queue / ready
2つの結果を一つのレビュー項目に束ねる。
- 00:30Human / 5 min
証拠を見て採用、修正依頼、破棄のいずれかを決める。
RECOMMENDATION 「レビューキューが空いたら委任する」「レビュー時間が埋まったら止める」という簡単なバックプレッシャーを持つだけでも、Agentの増やしすぎを抑えられます。
WHAT TO MEASURE
Agent数ではなく、未レビュー負債を見る
Agentを増やすと、見た目の進捗は増えます。しかし、レビューされていない成果物、戻すべき差分、決められていない選択肢も増えます。測るべきなのは、実行量と判断容量の関係です。
PROPOSED METRIC
Review Load Ratio = incoming review volume / human review capacity
1を超える状態が続くなら、Agentを追加する前にWIPを下げ、依頼を小さくし、レビュー形式をそろえます。これは一般標準ではなく、チームの容量を見るための運用上の提案です。
| 指標 | 問い | 悪化したときの手 |
|---|---|---|
| Intervention Rate | Agentが人の判断を必要とした割合 | Goal、停止条件、Contextを補う |
| Review Time | 成果物をレビュー可能になるまでの時間 | 出力契約と検証を定型化する |
| First-pass Acceptance | 最初のレビューで通った割合 | 受け入れ条件を具体化する |
| Rework Rate | 差し戻しややり直しの割合 | タスクの境界と依存を見直す |
| Review Debt | 未レビューの成果物がどれだけ溜まったか | 新規委任を止め、キューを減らす |
INTERPRETATION 速さを「Agentが何分動いたか」で見ると、人間側の詰まりが見えません。レビュー負債が増えず、最初のレビューで通る成果が増え、必要な介入が減るなら、並列化は機能しています。
START SMALL / KEEP THE LOOP
明日やることは、小さな一件でいい
人間の思考を無理に同時実行しようとすると、AIの速さが新しい疲労になります。まずは一つの問題を選び、独立した実行を広げ、レビューをまとめる。その小さなループから始めれば十分です。
BEFORE DELEGATION
- 主問題を一文で言える
- Goal / Scope / Non-goalsを書いた
- 受け入れ条件と検証方法がある
- 停止して質問する条件を決めた
- 失敗時に戻せる範囲に収めた
BEFORE ACCEPTANCE
- 変更内容を要約できる
- テストや画面確認の証拠がある
- 意図しない差分がない
- 残るリスクと人間の判断が明記されている
- 採用・修正・破棄を決められる
COPY / ADAPT
Goal: [一つの主問題]
Scope: [触ってよい範囲]
Non-goals: [今回は変えないもの]
Acceptance Criteria: [完了の条件]
Verification: [実行するテスト・画面確認]
Escalate only if: [止まる条件]
Output: Outcome / Changed / Verified / Risk / Human action
THE POINT
人間にもっと同時に考えさせることが、AI時代の生産性ではありません。人間が考えなくても前に進む仕事を増やし、人間が決める瞬間には、十分な証拠と静かな注意を残しておくことです。